for loop
우리가 흔히 알고 있는 반복문은 for과 while이 대표적인데
해당 조건이 만족할때까지 반복을 수행하는 작업을 해준다.
for은 아주 일반적인 반복 구조로
for(초기화; 테스트 표현식; 표현식 업데이트){

루프 내부의 코드

}
위 코드에 적힌 테스트 표현식의 조건이 false가 될때까지 반복되는 구조이다.
특정 인덱스를 조작하거나 표현할때 쓰이는 기본적인 방식이다.
        int size = list.size();
        for (int i = 0; i < size; i++) {
            list.add(i);
        }
여기서 테스트 표현식은 대부분 array의 length거나 list의 size가 되는 경우가 많은데
그럴 경우에는 반복문을 시작하기 전에 size를 미리 지정하여 불필요한 list.size()의 메소드를
반복하는 횟수 만큼 줄일 수 있고 가독성이 좋아질 수 있으니 반복 호출 없이 미리 size를 변수에 담고 그 변수를
테스트 표현식에 쓸 수 있도록 하자.
size를 미리 지정하여 나타나는 효과는 밑의 코드 사진에서 확인 할 수 있다.
그리고 중첩 반복문이 되어야 하는 상황에는 최대한 반복 루프가 적은 회수를 외부 중첩으로 사용해야
효율적이라고 한다.
for each loop
foreach는 향상된 for문이라고도 불린다.
루프 카운트가 필요하지 않고 컬렉션 또는 배열의 모든 요소를 처리해야 할 때 사용된다.
인덱스를 쓰지 않기에 ArrayIndexOutOfBoundsException 걱정이 전혀 필요 없고
명백한 정확성을 보장받는다.
Iterable 인터페이스를 구현한 객체만 이 for each loop를 사용할 수 있다.
임의 특정 요소를 관리하는데 사용하기엔 어렵다. ( 해당 인덱스 요소 제거 등 )
for(데이터 유형 항목: 컬렉션){

각 루프 내부의 코드

}
여기서 for과 for each를 사용하며 드는 다들 한번쯤은 해봤을 공감대가 있을텐데
        (1) Test test;
        for (int i = 0; i < 1000000; i++) {
            (1) test = new Test();
            (2) Test test = new Test();
        }
for문안에 객체를 불가피하게 생성하여야 할 때
(1)번의 방법이 올바른가 (2)번의 방법이 올바른가에 대한 고민이 있을 수도 있는데
우리가 객체지향 자바에 대해 처음부터 공부할 때 배웠듯
껍데기가 어디있던 결국 구현체를 생성하는 new가 중요한것이기에 메모리 관점으로 똑같다고 보면 되고
이왕이면 반복문이 종료되면서 스코프도 종료되는 (2)번의 방법이 옳다고 볼 수 있다.
for loop vs for each loop
Effective Java에 따르면 for each를 사용할 수 없는 3가지 상황이 있다고 한다.
1. 컬렉션을 순회하면서 선택된 원소를 제거해야하는 경우 반복자의 remove메소드를 호출해야하는 상황
2. 리스트나 배열을 순회하며 그 원소의 값 일부 혹은 전체를 교체하려고 하여 그에 대한 인덱스가 필요한 경우
3. 여러 컬렉션을 병렬로 순회하려면 각각의 반복자와 인덱스 변수를 사용해 엄격하고 명시적으로 사용해야함.
이 3가지 상황에 하나라도 속하면 for loop를 사용하라고 한다
성능 저하도 없다고 나와있는데 모든 경우에 그런가 테스트를 해보았는데.
정말 자주 쓰이는 컬렉션인 ArrayList로 테스트를 해보았다.
        for (int i = 0; i < 1000000; i++) {
            list.add(i);
        }
1,000,000개의 데이터를 가진 List로 계산을 돌려보았다.
        // for loop
        startTime = System.nanoTime();

        for (int j = 0; j < list.size(); j++) {
            int a = list.get(j);
        }

        endTime = System.nanoTime();
        runningTime = endTime - startTime;

        System.out.println("for loop : " + runningTime / 1000000.0 + " ms");


        // for each loop
        startTime2 = System.nanoTime();

        for (int i : list) {
            int a = i;
        }

        endTime2 = System.nanoTime();
        runningTime2 = endTime2 - startTime2;

        System.out.println("for each loop : " + runningTime2  / 1000000.0 + " ms");


        // Size 미리 계산 후 for loop
        startTime3 = System.nanoTime();

        int size = list.size();

        for (int j = 0; j < size; j++) {
            int a = list.get(j);
        }

        endTime3 = System.nanoTime();
        runningTime3 = endTime3 - startTime3;

        System.out.println("size 미리 계산 후 for loop: " + runningTime3 / 1000000.0 + " ms");
위 코드로 각각 값을 할당해주는 테스트를 JVM을 기준으로 시간을 찍는 nanoTime을 사용하여 10번정도 돌려본 결과
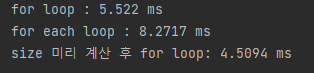
10번중 7번이 for loop가 빠른 결과가 나타났다.
결국 for loop가 효율이 조금 더 괜찮다는건데
for each는 내부 메서드들이 호출되기에 비용이 있기에 그렇다.
그런데 문제가 생겼다. 데이터를 10,000,000개로 지정한 뒤 진행한 결과는 조금 달랐다.
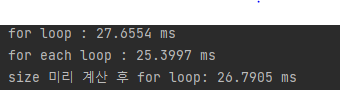
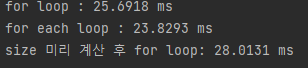
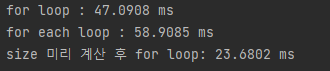
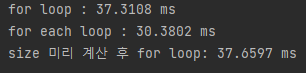
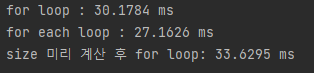
5번정도 실행을 해보니 foreach가 더 빠르게 나오는 경우가 많은데
700만개부터 소요 시간이 비슷해지는 것 같다.
이에 대한 이유는 시간복잡도에 대한 이해가 필요하다.
ArrayList get()메서드의 시간복잡도는 O(1)인데
O(1)은 N이 증가해도 속도가 일정하다는 의미이다.
만약 ArrayLIst에서 get()의 속도가 1초라고 생각한다면
for loop의 루프가 1000만번 돈다면 1초 * 1000만초가 되어버린다.
이렇게 반복 횟수가 많아지는 어느순간 foreach가 어떠한 내부적 동작의 이점으로
이겨버린게 아닐까 하는 생각인데 foreach가 이기는 이유에 대해 다시 공부하고 여기다 적겠다.
ArrayList에 for loop를 사용하면 배열과 마찬가지로 연속 메모리 블록이 할당되므로
시간복잡도가 O(1)이 되어 굉장히 좋지만 LinkedList가 되어버리면 연속 메모리 블록이 할당되지 않아
임의 엑세스가 불가능하므로 필요한 엑세스에 도달 할 때 까지
LinkedList를 순회해야하므로 최악의 경우 O(n)까지 시간복잡도가 증가한다고 한다.
반복자 vs Foreach in Java - GeeksforGeeks
foreach or iterator은 임의 엑세스가 없는 LinkedList같은 경우는 for each가 for loop보단 빠르지만
ArrayList나 배열 같은
순서가 있고 임의 엑세스를 허용하는 컬렉션에서는 for loop보다 빠르다고 할 수 없다.
LinkedList에서 for each가 유리한 이유는 for each를 타고 들어가다보면 Iterator에서
Itr라는 클래스를 반환해주는데 이 클래스안의 변수인 cursor가
LinkedList는 처음부터 그 앞전 요소들을 다 지나쳐 해당 인덱스 까지 가야하기에 O(N)의
시간 복잡도를 가지게 된다. (LinkedList의 get()메소드 내부에 반복문이 숨어있다.)
즉 ArrayList 또는 배열을 사용할때는 for loop 를 사용하고
LinkedList가 될 경우에는 foreach문을 사용하는게 성능적인 관점에서는 맞는 판단이라는데
(성능적인 면에서 RandomAccess Interface를 구현된 클래스 = for loop, 그렇지 않은 클래스 = for each)
이것 조차 상황에 따라 달라질 것 같다.
만약 지금 이 컬렉션들을 사용하여 해결하고자 하는 것이 알고리즘 해결이라고 하면
성능을 중요시 하니 전통 for loop를 사용하는게 맞을 수도 있다.
근데 지금 해결하고자 하는 것이 프로젝트이고 객체지향 관점으로 List를 선언한뒤
LinkedLIst, ArrayList 둘 중 어떤 구현체가 들어올지 모르는 상황 또는
성능에 크게 구애받지 않는 상황에서는 유연하고 명료하고 버그까지 줄일 수 있는
for each를 쓰는게 맞는 판단인 것 같다.
Stream? forEach?
우선 forEach는 스트림의 각 요소에 대한 작업을 수행해주는 메서드이고
보통 print와 같이 결과를 출력할 때 사용하는 최종 연산에 해당된다.
Stream을 이용하면 가독성이 좋고 중복코드들을 확실히 줄일 수 있는 대안이 된다고 생각한다.
(if문 난사와 for문을 최소화하기 때문에)
근데 Stream은 아주 신중하게 써야한다고 한다.
AngelikaLanger.com - 컨퍼런스 비디오 - GeeCon 2015 - Java 8 스트림의 성능 모델 - 안젤리카 랑거 - 안젤리카 랑거 교육 / 컨설팅
에 따른 타입에 따른 for loop와 Stream의 성능차이는
Primitive Type int array 일 경우 약 15배 정도 차이로 for loop가 우세하고
Wrapper Type ArrayList 일 경우 약 1.27배 정도 차이로 for loop가 우세하다.
Wrapper Type의 경우에 Stream과 for loop의 차이가 왜 조금밖에 나지 않느냐의 이유는
우선 for loop는 오랜 시간 컴파일러에 최적화 되어있고 Stream은 그렇지 않다는 기본 바탕이 깔려있고
Wrapper Type으로 사용할 시 Stack 영역이 아닌 Heap영역에 저장되어 있기에 간접참조를 해야하므로
for loop의 최적화 이점이 사라진다고 한다. 그래서 큰 차이가 나지 않는다고 한다.
그래서 Stream은 어떨 때 사용하냐
내부적인 함수 계산이 복잡한 그런 상황(함수의 시간복잡도가 큰 상황)에 Stream을 사용하면
시간 성능적으로도 for-loop와 비교했을 때 큰 차이도 없고 가독성까지 챙길 수 있다.
그리고 굳이 forEach를 사용하지 않더라도 Stream에서 제공하는 map이나 filter로 충분히 해결할 수 있는 상황이
나온다고 한다. 상황마다 사용을 신중히 고민해보자.
Stream을 사용하는 상황이 왔을때 forEach를 사용하는 경우가 있다.
Effective Java에선 forEach는 최종 연산 메서드 중에 기능이 가장 덜 스트림 다워서
계산 결과를 보고하는 형식으로만 쓰고 이걸 이용해서 무슨 계산을 하면 안된다고 한다.
꼭 주의하자.
결론은 Stream은 Collection, Wrapper를 사용하는 경우에 크기가 충분히 크고 그에 사용하고자 하는 함수의
시간복잡도가 충분한 상황에서 사용을 고려해봐야 한다.
그런데도 성능이 좋다고 무조건 for-loop만 고집하는것도 아니라고 한다. 성능이 중요한 프로젝트
가독성 및 유지보수가 중요한 프로젝트 등이 있을 것이고
위의 주의사항들을 충분히 고민하여 Stream을 사용할 것인지 for each를 사용 할 지 for loop를 사용 할 지
선택하면 될 것 같다.
Java Stream API는 왜 for-loop보다 느릴까? | by Sigrid Jin | Medium
Java Lambda Expression과 성능 (brunch.co.kr)
'JAVA' 카테고리의 다른 글
| 목적에 따른 다양한 List 생성과 효율적인 사용에 관하여 (0) | 2022.07.24 |
|---|